本篇文章我们来介绍 RAG 组件,让我们基于 Spring 简洁的 API 和模块化设计快速集成 RAG 能力,掌握使用 SpringAI 构建企业级智能问答系统、动态知识引擎等场景应用的开发方法,为打造专业领域的 AI 解决方案提供可靠技术路径。
什么是 RAG
检索增强生成(Retrieval-Augmented Generation,RAG) 是一种结合信息检索与生成式 AI 的技术,它的核心思想是在生成答案前,先从外部知识库中检索与用户问题相关的信息,并将这些信息作为提示(Prompt)输入模型,从而弥补 LLM 的静态知识局限。
用好理解的话来说,
RAG像是给AI配了一个检索知识的笔记本,在AI回答用户的问题之前,先要查一查这个笔记本也就是知识库有没有相关的知识,确保回答是基于真实资料而不是AI自己胡编乱造的。从技术角度看,
RAG在大语言模型生成回答之前,会先从外部知识库中检索相关信息,然后将这些检索到的内容作为额外上下文提供给模型,引导其生成更准确、更相关的回答。
为什么要用到 RAG
随着近两年大模型的不断地发展,大模型逐渐成为了我们日常办公场景中不可缺少的一环。但在使用过程中,会发现几个问题:
- 知识局限性问题:通用的大模型没有企业内部数据和用户数据,将私域数据上传第三方平台进行训练,存在着数据泄露的风险。从而导致大模型对一些内部数据无从学习,并不具备某一方面的知识,存在局限性。
- 幻觉问题:大模型底层的设计机制决定了它所生成的回答本质是基于概率而非既定事实的,导致只要大模型生成内容是符合它自己的语言逻辑的,就算内容与事实差了十万八千里,它也会毫不犹豫地输出。
- 时效性问题:模型知识的获取是通过使用训练数据集训练获取的,模型训练后产生的一些新知识,是没有学习的,而大模型训练成本极高,不可能为了弥补知识而频繁进行模型训练。
本质来看,大模型输出的结果都是以过去的公共数据进行归纳推理,没有固定的知识。那么假如我们给它外挂上一个知识库,是否就能解决这类问题呢?
RAG 就是我们的外挂知识库,简单的理解,在向大模型提问前,我们需要预先对大量私有化知识内容进行梳理,提取(检索)出与提问相关的知识内容后整合到 Prompt 中再向大模型提问,让大模型围绕“固定的知识”进行针对性回答。从而提升模型输出内容的准确性和可靠性(增强生成),如下图所示。

RAG 的作用
RAG 是一种结合了检索(Retrieval)和生成(Generation)的技术,其核心思想是:
- 检索:根据用户的问题,从知识库中检索出相关的文档或段落。
- 生成:基于检索到的内容,生成一个更准确、更相关的回答。
我们的项目通过 RAG 技术改造后,AI 就能:
- 准确回答关于特定内容的问题
- 在合适的时机推荐相关课程和服务
- 用特定的语气和用户交流
- 提供更新、更准确的建议
以下是 SpringAI 中 RAG 与传统 AI 模型的对比表格:
| 对比维度 | RAG(检索增强生成) | 传统AI模型 |
|---|---|---|
| 工作原理 | 结合检索外部知识库与生成模型,动态获取最新信息 | 依赖预训练模型的静态知识,无实时检索能力 |
| 知识更新 | 通过检索实时更新知识,避免模型重新训练 | 需重新训练或微调模型以更新知识 |
| 计算资源 | 需要额外检索模块,资源消耗较高 | 仅依赖模型推理,资源需求相对较低 |
| 适用场景 | 动态信息场景(如问答、客服),需高准确性 | 静态任务(如文本分类、摘要),无需实时数据 |
| 实现复杂度 | 需集成检索系统与生成模型,架构复杂 | 仅需调用单一模型,实现简单 |
| 响应延迟 | 因检索步骤可能增加延迟 | 延迟较低,适合实时性要求高的场景 |
| 可解释性 | 检索结果提供参考依据,增强输出可信度 | 输出依赖模型内部参数,可解释性较弱 |
| 典型工具 | Spring AI 的 VectorStore + 生成模型(如 GPT) |
单一模型(如 GPT、BERT) |
经过对比后我们会发现:
- 数据依赖性:
RAG依赖外部数据源的质量和覆盖范围,传统模型依赖训练数据的完备性。 - 灵活性:
RAG更适合开放域任务,传统模型在封闭域任务中表现更稳定。 - 维护成本:
RAG需维护检索系统,传统模型仅需定期更新训练数据。
RAG 的优势
- 生成的回答更加准确,因为它基于实际的知识库。
- 可以动态更新知识库,而无需重新训练模型。
- 适用于需要结合外部知识的场景,如问答系统、客服机器人等。
RAG 的工作流程
RAG 的实现主要分为检索和生成两大阶段。
- 检索:从向量数据库中检索与用户问题相关的文档。
- 生成:使用生成模型(如
OpenAI GPT)生成回答。

检索阶段
RAG 的重点之一在于如何对知识内容进行检索,比如说:关键词检索、相似度检索。
-
关键字检索
顾名思义就是我们日常工作中常见的检索方式,比如:通过输入订单标题关键词,模糊检索到订单信息。对于部分场景而言,使用关键词检索会高效快速得多。

-
相似度检索
使用各种不同的相似度算法(如欧氏距离、余弦等)进行数据检索的一种技术。简单理解,就是把问题
Embedding为向量,去向量数据库中匹配与此问题相似度最高的几个内容片段。相似度检索是
RAG中常用的检索方式,接下来我们展开说说如何利用相似度检索完成RAG的整个过程。-
知识分块处理
首先对数据库中的内容进行处理,比方说:把非文本形式的数据转换为标准的纯文本数据。然后将知识内容进行分块,切分成更短的段落或句子,以便更有效地进行处理。其中知识分块的策略会对最终知识片段的检索起到重要的影响。

-
知识向量化存储
把分成小块的知识片段通过一个嵌入模型转换成文本向量后创建索引并存储于向量数据库。向量通常会以数字的形式存储于一个多维空间中。

-
问题处理
当用户提问时,问题将通过和知识分块相同的嵌入模型与转换规则转化成查询向量,以保证问题和知识片段在相同的向量空间里,其中向量间的距离可以反映文本之间的语义相似度。

-
向量检索
被转换成向量的问题与向量数据库中存储的知识向量进行比较,找出与查询向量最相似的知识片段,这一步骤通常通过计算向量之间的距离(如余弦距离、欧氏距离等)来实现。

-
生成阶段
-
提示词工程
构建包含检索内容和用户查询的提示模版,设置系统角色和相关参数。
-
上下文增强生成
将检索到的文档作为上下文提供给大模型。然后大模型生成基于检索内容的准确回答。
总结来看,整个 RAG 流程大致如下图所示。

向量数据库
向量数据库是一种组织有序的向量嵌入集合,整合了可以随时创建、读取、更新和删除的向量嵌入。向量嵌入将数据块 (例如文本或图像) 表示为数值。

什么是向量数据库
向量数据库是一种特定类型的数据库,以多维向量的形式保存表示特定特征或品质的信息。专门用于存储和查询向量数据的数据库。
每个向量中的维度数量可以因数据的复杂性和详细程度而异,从几个到数千个不等。这些数据可能包括文本、图像、音频和视频,通过使用各种过程如机器学习模型、词嵌入或特征提取技术,被转化为向量。
向量数据库的主要优势在于其能够快速而准确地根据向量的接近程度或相似性定位和检索数据。这使得可以进行基于语义或上下文相关性的搜索,而不仅仅依赖于传统数据库中的精确匹配或设定的标准。

向量数据库的主要功能
- 管理:向量数据库以原始数据形式处理数据,能够有效地组织和管理数据,便于
AI模型应用。 - 存储:能够存储向量数据,包括各种
AI模型需要使用到的高维数据。 - 检索:向量数据库特别擅长高效地检索数据,这一个特点能够确保AI模型在需要的时候快速获得所需的数据。这也是向量数据库能够在一些推荐系统或者检索系统中得到应用的重要原因。
向量数据库的主要优点是,它允许基于数据的向量距离或相似性进行快速准确的相似性搜索和检索。这意味着,可以使用向量数据库,根据其语义或上下文含义查找最相似或最相关的数据,而不是使用基于精确匹配或预定义标准查询数据库的传统方法。向量数据库可以搜索非结构化数据,但也可以处理半结构化甚至结构化数据。
例如,可以使用向量数据库执行以下操作,根据视觉内容和风格查找与给定图像相似的图像,根据主题和情感查找与给定文档相似的文档,以及根据功能和评级查找与给定产品相似的产品。
向量数据库如何工作
传统数据库以表格格式存储简单的数据,如文字和数字。然而,向量数据库处理的是称为向量的复杂数据,并使用独特的搜索方法。
尽量使用常规数据库搜索确切的数据匹配,而向量数据库则寻找使用特定相似性度量的最接近匹配。
向量数据库采用称为近似最近邻搜索(ANN)的特殊搜索技术,其中包括哈希和基于图的搜索等方法。
假设一个图书馆就是一个数据库,而书就是数据库中的数据,在传统的教据库中,我们通过书名、作者、出版日期等关键词去搜索我们想要的书籍,这个过程类似于我们在数据库中通过关键词检索需要的数据。
在一个向量数据库中,假设读者不仅想找到一本特定的书,还想找到所有和这本书类似的书,例如内容、风格、主题都相似的书。这在传统图书馆中可能是一项极具挑战的任务,因为这需要逐一浏览和对比每一本书的内容。
在向量图书馆中,每本书都会被转换成一个向量,它像书的指纹,包含了书的所有特征信息。然后,我们可以通过计算这些向量之间的距离或相似度,找到与特定书最相似的其他书籍。这就是向量数据库的核心工作原理。
向量数据库检索核心
向量教据库的核心思想是将非结构化的文本信息转换为向量数据表示,再将转换后的向量数据以及原始文本一并存储在向量数据库。
当用户输入问题时,将问题描述转换为向量数据,在向量数据库中进行相似性计算,检索出与目标值最相似的向量以及上下文信息,最后将文本返回给用户。
下面是具体的操作流程:
-
生成并写入向量数据
向量数据可以来自各种数据源,例如文本、图像、音频等,每个向量数据都可以通过
Embedding模型生成一个对应的特征表示,即向量数据。向量数据库采用专门的数据结构和算法来存储和管理向量数据,以便快速地进行检索和分析。
-
建立向量索引
为了加速向量搜索,向量数据库通常会构建向量索引,通过计算和比较向量之间的相似度或距离,将向量数据有效地组织起来。以便数据库快速地定位和检索与查询条件最相关的向量集合。
-
向量搜索
在向量搜索中,用户输入一个查询向量,向量数据库通过相似性计算,会返回与查询向量最相似的向量,向量相似度通常使用余弦相似度、欧几里得距离等度量方式进行计算。
相似性搜索 (也称为向量搜索、向量相似性搜索或语义搜索) 是指人工智能应用程序根据指定的相似性度量标准,从数据库中高效地检索与给定查询的向量嵌入在语义上相似的向量的过程:
- 欧几里得距离:测量各点之间的直接距离。这对于总体差异至关重要的密集特征集的聚类或分类非常有用。
- 余弦相似度:关注向量之间的角度。非常适合文本处理和信息检索,根据方向 (而非传统的距离) 捕获语义相似性。
- 曼哈顿距离:计算笛卡尔坐标中的绝对差值之和。适用于类网格结构中的路由选择和优化问题。这对于稀疏数据很有用。
相似性衡量指标有助于在
AI聊天机器人、推荐系统和文档检索中高效检索相关项目。它们利用数据中的语义关系来指导生成式AI过程并执行自然语言处理 (NLP),从而增强用户体验。
什么是向量
向量是数学、物理学和工程学中的基本概念,指同时具有大小(模长)和方向且遵循平行四边形法则的量,可形象化为带箭头的线段。

向量数据就是 embedding 向量。向量的典型结构是一个一维教组,表示浮点数沿多个维度的位置,其中的元素是数值(通常是浮点数)。这些数值表示对象或数据点在多维空间中的位置、特征或属性。
更通俗的说法,向量是一个数字列表,例如:{12, 13, 19, 8, 9}。这些数字表示在空间中的一个位置,就像电子表格中的行和列号表示电子表格中的某个单元格(例如 B7)。
常用的数据向量
- 图像向量,通过深度学习模型提取的图像特征向量,这些特征向量捕捉了图像的重要信息,如颜色、形状、纹理等,可以用于图像识别、检索等任务;
- 文本向量,通过词嵌入技术如
Word2Vec、BERT等生成的文本特征向量,这些向量包含了文本的语义信息,可以用于文本分类、情感分析等任务; - 语音向量,通过声学模型从声音信号中提取的特征向量,这些向量捕捉了声音的重要特性,如音调、节奏、音色等,可以用于语音识别、声纹识别等任务。
什么是嵌入
要真正理解向量数据库的工作方式,以及它与传统关系数据库(如 SQL )的区别,我们首先必须了解嵌入(Embedding)的概念。
非结构化数据,如文本、图像和音频,缺乏预定义的格式,这给传统数据库带来了挑战。为了在人工智能和机器学习应用中利用这些数据,它们使用嵌入被转化为数值表示。
嵌入是一种将高维、非结构化的数据(如文本、图像、音频等)转化为低维、稠密的向量表示的技术。这些向量能够捕捉原始数据的语义信息和特征,使得机器可以像处理数值一样对这些数据进行计算和分析。

嵌入是由神经网络生成的向量。深度学习模型的典型向量数据库由嵌入组成。一旦神经网络被正确调整,它就能够自行生成嵌入,无需手动创建。这些嵌入可以用于相似性搜索、上下文分析、生成型人工智能等。
以文本数据为例,“猫” 和 “狗” 这两个词,在自然语言中它们都是常见的动物,具有一定的关联性。通过嵌入技术,它们会被转化为两个向量,这两个向量在空间中的距离会比较近,因为它们的语义相关度较高;而 “猫” 和 “汽车” 这两个语义关联度较低的词,转化后的向量在空间中的距离则会相对较远。
这种向量表示的优势在于,它能够将原本难以量化的语义信息转化为可计算的数值,从而支持各种机器学习任务,如相似度计算、聚类分析、分类等。在 RAG 中,嵌入技术能够将用户的查询和知识库中的文档都转化为向量,通过计算向量之间的相似度,快速找到与查询相关的文档,为后续的生成步骤提供有力支持。
实质上,嵌入充当一个桥梁,将非数值数据转换为机器学习模型可以处理的形式,使它们能够更有效地识别数据中的模式和关系。
什么是嵌入模型
嵌入模型是实现嵌入技术的核心工具,它是一种经过训练的机器学习模型,能够自动将输入的非结构化数据映射为对应的嵌入向量。
嵌入模型会将各种数据 (例如文本、图像、图表和视频) 转换为数值向量,以便捕捉其在多维向量空间中的含义和细微差别。嵌入技术的选择取决于应用需求,同时要兼顾语义深度、计算效率、要编码的数据的类型、维度等因素。

通过将向量映射到多维空间,可以对向量的语义相似性进行细致的分析,从而显著提高搜索和数据分类的准确性。在使用 AI 聊天机器人、大语言模型 (LLM)、检索增强生成 (RAG) 和向量数据库的 AI 应用中以及在搜索引擎和许多其他用例中,嵌入模型发挥着至关重要的作用。
常见的文本嵌入模型有
Word2Vec、GloVe、BERT的衍生模型(如Sentence-BERT)等。不同的嵌入模型在设计理念、训练数据和适用场景上可能存在差异。例如,Word2Vec主要关注词语级别的嵌入,能够生成单个词语的向量;而Sentence-BERT则专门针对句子级别的嵌入进行优化,可以生成整个句子的向量,更适合处理句子或短文本的语义表示。
在 RAG 系统中,嵌入模型的性能直接影响检索的准确性和效率。一个优秀的嵌入模型能够生成高质量的嵌入向量,准确捕捉文本的语义,使得检索到的文档与用户查询高度相关,从而为生成更精准的回答奠定基础。
嵌入模型如何与向量数据库搭配使用
提取私有企业数据后,系统会将这些数据分块,创建一个向量来表示它们,并将数据块及其对应的向量同可选的元数据一起存储在向量数据库中,以供日后检索。

在收到用户、聊天机器人或 AI 应用发来的查询后,系统会对其进行解析,并使用嵌入模型来获取代表提示的各个部分的向量嵌入。然后,使用提示的向量在向量数据库中执行语义搜索,以找到确切匹配或相似度排名前 K 位的向量及其相应的数据块,这些数据块会被放入到提示的上下文中,然后被发送给 LLM。
与传统数据库的区别
向量数据库和传统数据库的区别主要体现在以下几个方面:
数据模型
- 向量数据库:采用向量模型,将数据以向量的形式表示和处理。向量模型更适合存储和处理高维度的向量数据,例如特征向量、图像、音频等。
- 传统数据库:通常采用关系模型,使用表格来组织和表示数据,其中数据以行和列的形式存储。
存储结构
- 向量数据库:采用向量索引结构,例如倒排表、哈希索引或基于树的结构(如球树、
KD树、HNSW、IVF等),以支持高效的向量查询。这些结构能够利用向量之间的相似度进行快速匹配和检索。 - 传统数据库:通常使用
B树等数据结构来组织和存储数据,以支持快速的索引和查询操作。
查询处理
- 向量数据库:采用向量化计算的方式,通过向量间的相似度计算和距离度量(如欧几里得距离、余弦相似度)来进行高效的向量查询。这种查询方式能够快速找到相似的向量数据,适用于复杂的机器学习算法和深度学习模型。
- 传统数据库:查询通常基于关系代数和
SQL语言进行,通过JOIN、GROUP BY等操作来处理关系数据。
应用场景
- 向量数据库:广泛应用于人工智能和大数据领域,如语义搜索、推荐系统、图像检索、语音和音频处理、异常检测等。这些场景通常需要处理高维、连续的数值数据,并进行相似性搜索。
- 传统数据库:适用于存储和管理结构化数据,如企业资源规划(
ERP)、客户关系管理(CRM)等系统中的数据。这些系统通常需要保证数据的一致性和完整性,并支持事务处理。
扩展性和性能
- 向量数据库:设计时考虑了扩展性,能够处理和存储大规模的向量数据,同时保持高效的查询性能。许多向量数据库采用分布式架构,能够在多台服务器之间分布存储和计算任务。
- 传统数据库:虽然也具有大规模处理能力,但在处理高维向量数据时可能面临效率问题。不过,传统数据库在事务处理、数据一致性等方面具有优势。
综上所述,向量数据库和传统数据库在数据模型、存储结构、查询处理、应用场景以及扩展性和性能等方面存在显著差异。选择哪种数据库取决于具体的应用场景和需求。
常见的向量数据库
在人工智能时代,向量数据库已成为数据管理和 AI 模型不可或缺的一部分。向量数据库是一种专门设计用来存储和查询向量嵌入数据的数据库。这些向量嵌入是 AI 模型用于识别模式、关联和潜在结构的关键数据表示。随着 AI 和机器学习应用的普及,这些模型生成的嵌入包含大量属性或特征,使得它们的表示难以管理。
这就是为什么数据从业者需要一种专门为处理这种数据而开发的数据库,这就是向量数据库的用武之地。下来罗列集中常见的向量数据库:
MongoDB
MongoDB 是一个开源、高性能、无模式的文档型数据库,是 NoSQL 数据库产品中的一种,被设计用于简化开发和方便扩展。它以 BSON(Binary-JSON)文档的格式存储数据,支持的数据结构非常松散,类似于 JSON,既可以存储复杂数据类型,又具有很高的灵活性。

MongoDB 的最小存储单位是文档对象,文档对象对应于关系型数据库的行。BSON 是一种类 JSON 的二进制形式存储格式,支持内嵌的文档对象和数组对象,还包含一些 JSON 没有的数据类型,如 Date 和 BinData 类型。BSON 具有轻量性、可遍历性、高效性的特点,但空间利用率不太理想。
- 特点
- 高性能:支持嵌入式数据模型,减少
I/O活动,索引支持更快的查询,还支持多种存储引擎,如wiredtiger、in-memory等,以满足各种场景需求。 - 高可用性:通过副本集提供自动故障转移和数据冗余,确保数据的高可用性。
- 高扩展性:分片将数据分布在一组集群的机器上,从 3.4 开始,支持基于片键创建数据区域,实现水平可扩展性。
- 丰富的查询支持:支持丰富的查询语言,包括
CRUD操作、数据聚合、文本搜索和地理空间查询等。
- 高性能:支持嵌入式数据模型,减少
- 应用场景
- 社交场景:存储用户信息、朋友圈信息等,可通过地理位置索引实现附近的人、地点等功能。
- 游戏场景:存储游戏用户信息、装备、积分等,以内嵌文档的形式存储,方便查询和更新。
- 物流场景:存储订单信息,订单状态的变更以嵌入数组的形式存储,一次查询就能读取所有变更。
- 物联网场景:存储智能设备信息和设备汇报的日志信息,并进行多维度分析,可通过分片集群实例实现性能和存储空间的无限扩展。
- 视频直播:存储用户信息、点赞互动信息等。
- 适用情况
- 应用不需要事务及复杂
join支持。 - 新应用,需求会变,数据模型无法确定,想快速迭代开发。
- 应用需要 2000 – 3000 以上的读写
QPS。 - 应用需要
TB甚至PB级别数据存储。 - 应用发展迅速,需要能快速水平扩展。
- 应用要求存储的数据不丢失。
- 应用需要 99.999% 高可用。
- 应用需要大量的地理位置查询、文本查询。
- 应用不需要事务及复杂
Chroma
Chroma DB 是一个开源的、AI 本地的嵌入式向量数据库,旨在简化通过使知识、事实和技能对大型语言模型(LLM)规模上的机器学习模型可插拔,从而创建由自然语言处理驱动的 LLM 应用程序的过程,同时避免幻觉。

许多工程师都希望能够拥有一个为数据设计的 ChatGPT,ChromaDB 通过基于嵌入的文档检索提供了这种链接。它还提供了一站式服务,团队需要存储、嵌入和查询数据的一切都在其中,包括强大的过滤功能,还有如智能分组和查询相关性等更多功能即将推出。
Elasticsearch
Elasticsearch 是一个开源的、分布式的、RESTful 的分析引擎,可以处理文本、数值、地理、结构化和非结构化数据。基于 Apache Lucene,最初于2010年由 Elasticsearch N.V.(现称 Elastic )发布。Elasticsearch 是 Elastic 堆栈的一部分,这是一套免费且开源的工具,用于数据摄入、丰富、存储、分析和可视化。
官方网站:https://www.elastic.co/cn/elasticsearch/vector-database

Elasticsearch 可以处理各种用例——它集中存储数据,以实现快速搜索、微调相关性以及可轻松扩展的高级分析。它可以水平扩展以容纳每秒数十亿的事件,同时自动控制索引和查询在整个集群中的分布,以实现流畅的操作。
Milvus
Milvus 是一个开源的向量数据库,旨在促进向量嵌入、高效相似搜索和 AI 应用。它于2019年10月以开源 Apache 2.0 许可证发布,目前是 LF AI & Data Foundation 赞助的毕业项目。

该工具简化了非结构化数据的搜索,并提供了与部署环境无关的统一用户体验。为了提高弹性和适应性,Milvus 2.0 重构版本中的所有组件都是无状态的。
Milvus 的应用案例包括图像搜索、聊天机器人和化学结构搜索。
Elasticsearch 数据库
Elasticsearch 是世界上部署最广泛的开源向量数据库,为您提供大规模、高效地创建、存储和搜索向量嵌入的有效方法。借助 Elastic 的企业级向量数据库,即使数据快速变化,您也可以实现快速查询时间和最佳性能。它可根据扩展进行构建,在简化开发流程的同时提供相关的个性化搜索结果。
Elasticsearch 的介绍
Elasticsearch 是⼀个开源,基于 Apache Lucene 库构建的 Restful 搜索引擎。Elasticsearch 是在 Solr 之后⼏年推出的。提供了⼀个分布式,多租户能⼒的全⽂搜索引擎,具有 HTTP Web 界⾯和⽆架构 JSON ⽂档。
Elasticsearch 的官⽅客户端库提供 Java,Groovy,PHP,Ruby,Perl,Python,.NET 和 Javascript 版本的 API。
核心概念
-
索引
在技术领域,索引这个词已经用得太多了。如果您要问开发人员什么是索引,他们大多数人都可能会告诉您,索引通常是指关系数据库中与表相关联的一种数据结构,可以提高数据检索操作的速度。
那么,
Elasticsearch索引又是什么呢?Elasticsearch索引是一个逻辑命名空间,其中包含一系列的文档,每个文档是一系列的字段,而字段又是包含数据的键值对。Elasticsearch索引与关系数据库中的索引不同。如果将Elasticsearch集群视为一个数据库,它可以包含许多索引,您可以将它们看作是一张表,在每个索引内,有许多文档。 -
映射
映射(
Mapping)是定义索引中文档结构和字段类型的元数据,类似于关系型数据库中的表结构定义。它描述了文档可能包含的字段、每个字段的数据类型(如string、integer、date等),以及字段的存储方式(如是否被索引、是否包含在全文搜索中)。 -
文档
在大多数应用中,多数实体或对象可以被序列化为包含键值对的
JSON对象。 一个键可以是一个字段或字段的名称,一个值可以是一个字符串、一个数字、一个布尔值、另一个对象、一些数组值或一些其它特殊类型诸如表示日期的字符串,或代表一个地理位置的对象:{ "name": "John Smith", "age": 42, "confirmed": true, "join_date": "2014-06-01", "home": { "lat": 51.5, "lon": 0.1 }, "accounts": [ { "type": "facebook", "id": "johnsmith" }, { "type": "twitter", "id": "johnsmith" } ] }通常情况下,我们使用的术语对象和文档是可以互相替换的。不过,有一个区别: 一个对象仅仅是类似于
hash、hashmap、字典或者关联数组的JSON对象,对象中也可以嵌套其他的对象。 对象可能包含了另外一些对象。在
Elasticsearch中,文档有着特定的含义。它是指最顶层或者根对象,这个根对象被序列化成JSON并存储到Elasticsearch中,指定了唯一ID。文档是真正的数据,存储一条数据就是一份文档,存储格式为
JOSN,等同于mysql中的一条数据。
应用场景
-
全文搜索
Elasticsearch凭借其强大、可扩展和快速的搜索功能,在全文搜索场景中表现出色。它允许用户以近乎实时的响应执行复杂的查询,常用于大型网站和应用程序的搜索功能。 -
实时分析
Elasticsearch能够实时执行分析,适用于跟踪实时数据(如用户活动、交易或传感器输出)的仪表盘。它可以对结构化和非结构化数据进行索引和分析,支持聚合操作和复杂的数据可视化。 -
机器学习
通过在
Elasticsearch的X-Pack中添加机器学习功能,可以自动检测数据中的异常、模式和趋势,为数据分析和预测提供有力支持。 -
地理数据应用
Elasticsearch通过地理空间索引和搜索功能支持地理数据,这对于需要管理和可视化地理信息的应用程序(如地图和基于位置的服务)非常有用。它使得执行邻近搜索和基于位置的数据可视化成为可能。 -
日志和事件数据分析
Elasticsearch常用于聚合、监控和分析来自各种来源的日志和事件数据。它是ELK堆栈(Elasticsearch、Logstash、Kibana)的关键组件,用于管理系统和应用程序日志,以识别问题和监控系统运行状况。 -
安全信息和事件管理(
SIEM)Elasticsearch可用作SIEM工具,帮助企业实时分析安全事件,提高网络安全防护能力。 -
电子商务
Elasticsearch在电子商务领域也有广泛应用,可用于构建电子商务网站的产品搜索功能。它可以根据用户的查询实时地返回相关的产品结果,并支持过滤、排序和推荐等功能。 -
推荐系统
基于用户的行为和兴趣,
Elasticsearch可以构建推荐系统,推荐相关的内容和产品,提升用户体验和转化率。 -
数据集成和同步
Elasticsearch能够集成和同步多个数据源的数据,提供统一的查询接口和分析能力,有助于实现数据整合和统一管理。 -
业务分析
Elasticsearch还可用于企业数据分析、市场调研等业务分析场景。它可以对海量数据进行搜索、聚合和分析,支持多种数据格式和数据源,帮助用户了解业务情况、市场趋势等。
综上所述,Elasticsearch 适用于需要大规模数据存储、实时搜索和分析的场景,特别是对于结构化和非结构化数据的全文搜索和聚合分析。它的高性能、可扩展性和易用性使得它成为许多企业和开发者的首选工具。
Elasticsearch 的安装
安装前的准备
在安装 elasticsearch 前,需要做好一系列准备工作以确保安装过程顺利,并为后续的稳定运行和高效使用奠定基础。
-
安装
JDK17Elasticsearch依赖于Java运行环境。确保安装的是兼容的Java版本(通常要求Java 17或更高版本)。在
centos7中如何安装JDK17已经在前边的章节中讲到过,这里唯一需要注意的是:## 配置java环境变量文件最底部引入以下内容,注意具体路径 export JAVA_HOME=/opt/soft/java/jdk-17.0.8 # export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin注释掉
CLASSPATH,因为JDK17后已经去掉了rt.jar包了,如果不注释,启动elasticsearch后会报找不到rt.jar的错误。刷新编译文件
source /etc/profile最好重启虚拟机,有的时候
JDK刷新不起作用。 -
创建
centos的用户因为
elasticsearch不能用root用户直接启动。需要单独创建用户:# 创建用户名为 elasticsearch 的用户 useradd elasticsearch # 设置该用户的密码 passwd elasticsearch需要注意的是:在启动之前的步骤中都是以
root用户进行操作的,只有启动命令是以该用户运行。 -
修改系统设置
修改最大虚拟内存区域
# 修改配置文件 vim /etc/sysctl.conf # 最后一行增加配置,一个进程在VMAs(虚拟内存区域)创建内存映射最大数量 vm.max_map_count=262144 # 重启生效 sysctl -p -
修改系统设置
修改配置文件可限制文件打开数,系统进程等资源。
# 修改配置文件
vim /etc/security/limits.conf
# 追加下面的内容
* soft nofile 65536
* hard nofile 131072
* soft nproc 4096
* hard nproc 4096
# 重启虚拟机
reboot
开始安装
下来我们开始安装向量数据库 elasticsearch 。安装的版本是 8.15.5。
-
下载
我们可以到官网中去下载,然后上传到
centos7中,也可以直接在centos7中进行下载wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-8.15.5-linux-x86_64.tar.gz这里下载的版本是
8.15.5。
下载好后进行解压就成。
-
配置默认
JDK进入到解压后目录中的子目录
bin
修改启动文件
elasticsearch#!/bin/bash ############## 添加配置解决jdk版本问题 ############## # 将jdk修改为es中自带jdk的配置目录 export JAVA_HOME=/opt/soft/elasticsearch/elasticsearch-8.15.5/jdk export PATH=$JAVA_HOME/bin:$PATH if [ -x "$JAVA_HOME/bin/java" ]; then JAVA="/opt/soft/elasticsearch/elasticsearch-8.15.5/jdk/bin/java" else JAVA=`which java` fi CLI_NAME=server CLI_LIBS=lib/tools/server-cli source "`dirname "$0"`"/elasticsearch-cli注意:这里的路径是你自身
elasticsearch的解压路径。 -
修改
JVM的内存设置进入安装包下的
config目录,编辑jvm.options-Xms512m -Xmx512m内存大小根据自身情况设置。
512m的内存是最小设置,如果启动后提示内存不足,请自行提升。 -
配置加密证书
Elasticsearch有两个级别的通信:传输层通信和HTTP层通信。传输协议用于Elasticsearch节点之间的内部通信,HTTP协议用于从客户端到Elasticsearch集群的通信。由于Elasticsearch集群中的每个节点都是客户端和集群中其他节点的服务器,因此所有传输证书都必须是客户端和服务器证书。Elasticsearch附带了一个名为elasticsearch-certutil的实用程序,可用于生成加密Elasticsearch集群内部通信的自签名证书,证书生成命令如下:# 在解压后的目录下运行 bin/elasticsearch-certutil ca bin/elasticsearch-certutil cert --ca elastic-stack-ca.p12输入密码那一块直接回车,不要设置密码。其后会生成两个证书文件:

将两个证书文件移动到
config目录下的certs目录下。 -
修改
elasticsearch.yml修改
config目录下的配置文件elasticsearch.yml:#节点名称 node.name: node-1 #允许所有ip访问 network.host: 0.0.0.0 #端口(默认9200) http.port: 9200 #日志信息输出目录(按需求修改) path.data: /opt/soft/elasticsearch/elasticsearch-8.15.5/data path.logs: /opt/soft/elasticsearch/elasticsearch-8.15.5/logs # 集群发现种子节点列表(集群部署配多个),默认["127.0.0.1"] discovery.seed_hosts: ["localhost"] # 手动指定可以成为 mater 的所有节点的 name 或者 ip,这些配置将会在第一次选举中进行计算(可配多>个) cluster.initial_master_nodes: ["node-1"] # 禁用X-Pack的机器学习功能 xpack.ml.enabled: false #自动写入的安全配置 # Enable security features xpack.security.enabled: true xpack.security.enrollment.enabled: true # Enable encryption for HTTP API client connections, such as Kibana, Logstash, and Agents xpack.security.http.ssl: enabled: false keystore.path: certs/elastic-certificates.p12 # Enable encryption and mutual authentication between cluster nodes xpack.security.transport.ssl: enabled: true verification_mode: certificate keystore.path: certs/elastic-certificates.p12 truststore.path: certs/elastic-certificates.p12 -
设置权限
为了保证
elasticsearch用户拥有足够的权限访问我们的应用,我们这里需要给该用户权限:sudo chown -R elasticsearch:elasticsearch /opt/soft/elasticsearch设置
elasticsearch目录的属主和属组。
启动
我们需要切换到 elasticsearch 用户下进行启动:
# 首先进入到 bin 目录
cd bin
# 启动
sh ./elasticsearch
# 如果要后台启动,使用 第一次建议前台启动
sh ./elasticsearch -d
启动会比较慢一些,第一次启动后会生成一个随机的密码(请记住)。

下来通过浏览器访问,能看到如下情况就代表启动成功了:

一些其他命令:
查询所有内容的命令:http://124.220.170.254:9200/_search
查询某个索引的命令:http://124.220.170.254:9200/索引名/_search
修改密码
这个步骤可以不做,每次使用原始密码也行。
修改原始密码,需要在 elasticsearch 启动下执行,重新开个窗口,切换到 bin 目录。我们有两种方式重制密码:
-
重置密码
重置密码会重新生成一个强规则的随机密码
./elasticsearch-reset-password -u 账号 -
自定义密码
自定义自己的密码,建议密码复杂。
./elasticsearch-reset-password -u 账号 -i a123456
VectorStore 的操作
SpringBoot 整合 Elasticsearch 是企业级开发中常见的需求,用于实现高效的全文检索、日志分析等功能。
在这里,我们会结合 SpringAI 来对向量数据库进行操作。我们选择的组件为 VectorStore。SpringAI 中的 VectorStore 是一种用于存储和检索高维向量数据的数据库或存储解决方案,它在 AI 应用中扮演着至关重要的角色。
VectorStore 特别适用于处理那些经过嵌入模型转化后的数据。在 VectorStore 中,查询与传统关系数据库不同,它执行的是相似性搜索,而非精确匹配。当给定向量作为查询时,它会返回与查询向量相似的向量。
VectorStore 主要用于将数据与 AI 模型集成。它存储并支持对这些向量的相似性搜索,为 AI 模型提供丰富的上下文信息,从而实现更精确、更智能的回复。这种技术被称为检索增强生成。
环境要求
Elasticsearch:需先安装并启动,这里使用到的版本是8.15.5。Spring Boot:因为后期AI依赖高版本Boot,这里使用的版本是3.4.5。- JDK:最低要求
17。 Ollama中安装文本嵌入模型nomic-embed-text。
拉取文本嵌入模型
进入 Ollama 的官网,在模型中拉取 nomic-embed-text 模型。

ollama pull nomic-embed-text拉取成功后,在本地中就能看到它。

nomic-embed-text模型和向量数据库的关系:
nomic-embed-text作为开源文本嵌入模型,核心功能是将文本转换为高维向量(捕捉语义信息),而向量数据库需要这种结构化的数据才能实现高效检索。
添加依赖
我们使用了本地向量模型,使用了 Elasticsearch 数据库,引入如下依赖:
<dependencies>
    <!-- Spring AI Ollama -->

<dependency>

<groupId>org.springframework.ai</groupId>

<artifactId>spring-ai-starter-model-ollama</artifactId>
    </dependency>
    <!-- 向量数据库依赖(如 Elasticsearch ) -->

<dependency>

<groupId>org.springframework.ai</groupId>

<artifactId>spring-ai-starter-vector-store-elasticsearch</artifactId>
    </dependency>
    <!-- 兼容的Elasticsearch客户端 -->

<dependency>

<groupId>co.elastic.clients</groupId>

<artifactId>elasticsearch-java</artifactId>

<version>8.14.1</version>
    </dependency>

<dependency>

<groupId>org.elasticsearch.client</groupId>

<artifactId>elasticsearch-rest-client</artifactId>

<version>8.14.1</version>
    </dependency>
</dependencies>
仅仅展示了 Elasticsearch 相关依赖,未显示 mvc 、测试等依赖。
配置文件
spring:
  elasticsearch:
    password: 你的密码
    username: elastic
    uris: http://124.220.170.254:9200
  ai:
    ollama:
      embedding:
        model: nomic-embed-text  # 文本嵌入模型
      base-url: http://localhost:11434
    vectorstore:
      elasticsearch:
        initialize-schema: true
        index-name: vectorstore # 用于存储向量的索引的名称
        dimensions: 768  # 向量中的维数
        similarity: cosine # 要使用的相似性函数
相关操作
Spring AI 框架通过 VectorStore 接口为向量数据库交互提供了抽象化的 API。VectorStore 接口定义了以下核心操作:
- 添加文档:
void add(List documents),将文档添加到向量数据库中。 - 删除文档:
Optional delete(List idList),从向量数据库中删除指定ID的文档。 - 相似性搜索:
List similaritySearch(String query),根据查询字符串进行相似性搜索,返回相似的文档列表。List similaritySearch(SearchRequest request),根据SearchRequest对象进行更复杂的相似性搜索。其中,SearchRequest对象允许开发者微调相似性搜索的参数,如指定要返回的相似文档的最大数量(topK)、相似度阈值(threshold)以及基于元数据的过滤表达式(filterExpression)。
添加文档
@Test
public void add1() {
    List
<Document> documents = List.of(
      new Document("I like SpringAI"),
      new Document("I like SpringBoot"),
      new Document("I like ElasticSearch")
    );
    vectorStore.add(documents);
}
相似性搜索
// 根据查询字符串进行相似性搜索,返回相似的文档列表。
@Test
public void find1() {
    // 默认情况下,返回的数据为4条。
    List
<Document> documents = vectorStore.similaritySearch("I like");
    documents.forEach(e -> log.info("e:{}", e));
}
// 根据SearchRequest对象进行更复杂的相似性搜索。
@Test
public void find2() {
String question = "I like";
int top = 6;
double threshold = 0.2;
SearchRequest searchRequest = SearchRequest.builder()
.query(question) // 问题
.topK(top) // 返回的条数
.similarityThreshold(threshold) // 相似度阈值
.build();
List
<Document> documents = vectorStore.similaritySearch(searchRequest);
documents.forEach(e -> log.info("e:{}", e));
}注意:这里的参数是选填的,可以全填,也可以部分填写。
如果要实现获取全部文档,可以通过:
// 根据SearchRequest对象进行全搜索。
@Test
public void find3() {
    int top = 1000;
    double threshold = 0.0;
    SearchRequest searchRequest = SearchRequest.builder()
        .topK(top)  // 返回的条数尽量填写很大
        .similarityThreshold(threshold)   // 相似度为0
        .build();
    List
<Document> documents = vectorStore.similaritySearch(searchRequest);
    documents.forEach(e -> log.info("e:{}", e));
}
删除文档
根据 id 删除一个或者多个文档。
@Test
public void remove() {
    List
<String> ids = List.of("id1", "id2",....);
    vectorStore.delete(ids);
}
根据搜索结果删除文档
// 根据查询出来的结果进行删除
@Test
public void remove2() {
      String question = "I like";
    int top = 6;
    double threshold = 0.2;
    SearchRequest searchRequest = SearchRequest.builder()
        .query(question) // 问题
        .topK(top)  // 返回的条数
        .similarityThreshold(threshold)   // 相似度阈值
        .build();
    List
<Document> documents = vectorStore.similaritySearch(searchRequest);
    List
<String> removeIds = documents.stream().map(Document::getId).toList();
    vectorStore.delete(removeIds);
}
同理,删除全部文档,可以先将所有文档检索出来,再进行删除。
引入外部文档
我们除过使用 add1 的写法外,还可以将外部文档导入到 Elasticsearch 中。
-
导入依赖
<!-- pdf文件读取 -->
根据自身文件类型来选择合适的依赖。
2. 外部文档

内容依次分别是:
```tex
温度15度到22度之间适合穿长领风衣
温度5-15度之间适合穿毛衣
温度大于22度适合穿着T恤 ⻄安九⽉三⽇的天⽓是⼤⾬,温度18度。 西安9月1日天气是晴天,温度21度-
导入到向量数据库
// 导入文本文件到向量库中
@Value("classpath:text-source.txt")
private org.springframework.core.io.Resource txtResource;

@Test
public void add2() {
    TextReader txtReader = new TextReader(txtResource);
    List
<Document> documents = txtReader.get();

    // 转换:按Token拆分
    TokenTextSplitter splitter = new TokenTextSplitter();
    List
<Document> chunks = splitter.apply(documents);

    // 加载: 存储到ES向量数据库
    vectorStore.add(chunks);
}
// 导入pdf文件到向量库中 @Value("classpath:pdf-source.pdf") private org.springframework.core.io.Resource pdfResource; @Test public void add3() { PagePdfDocumentReader pdfReader = new PagePdfDocumentReader(pdfResource); List <Document> documents = pdfReader.get(); // 转换:按Token拆分 TokenTextSplitter splitter = new TokenTextSplitter(); List <Document> chunks = splitter.apply(documents); // 加载: 存储到ES向量数据库 vectorStore.add(chunks); }// 导入markdown文件到向量库中 @Value("classpath:markdown-source.md") private org.springframework.core.io.Resource makedownResource; @Test public void add3() { MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder() .withHorizontalRuleCreateDocument(true) .withIncludeCodeBlock(false) .withIncludeBlockquote(false) .withAdditionalMetadata("filename", makedownResource.getFilename()) .build(); MarkdownDocumentReader markdownDocumentReader = new MarkdownDocumentReader(makedownResource, config); List <Document> documents = markdownDocumentReader.get(); // 转换:按Token拆分 TokenTextSplitter splitter = new TokenTextSplitter(); List <Document> chunks = splitter.apply(documents); // 加载: 存储到ES向量数据库 vectorStore.add(chunks); }
搭建本地 RAG 系统
RAG 听起来很高大上,其实就是检索增强生成的意思。简单来说,就是让 AI 先从你的文档中找到相关内容,然后基于这些内容来回答你的问题。

依赖管理
跟 VectorStore 操作基本一致。需要注意的是要引入 ai 大模型的依赖。
配置文件
spring:
  application:
    name: boot-ai-ollama-rag-elasticsearch
  elasticsearch:
    uris: http://124.220.170.254:9200
    username: elastic
    password: 你的密码
  ai:
    vectorstore:
      elasticsearch:
        initialize-schema: true
        index-name: vectorstore #用于存储向量的索引的名称
        dimensions: 768  #向量中的维数
        similarity: cosine #要使用的相似性函数
    ollama:
      base-url: http://localhost:11434  # ollama服务地址
      chat:
        options:
          model: deepseek-r1:7b
          temperature: 1
          keep-alive: 5m
      embedding:
        enabled: true  # 启用 Ollama 嵌入模型自动配置
        options:
          model: nomic-embed-text
          truncate: true # 是否截断输入
          temperature: 0.3 # 模型温度
注意:如果文本模型使用在线大模型,那么嵌入模型也要使用在线模型。
配置类
书写对于 Ollama 操作的配置类
@Configuration
public class ChatClientConfig {
    @Resource
    private OllamaChatModel ollamaChatModel;

    @Bean(name = "ollamaChatClient")
    public ChatClient ollamaChatClient() {
        return ChatClient.builder(ollamaChatModel)
                .defaultSystem("你好.")
                .defaultAdvisors(new MessageChatMemoryAdvisor(new InMemoryChatMemory()))
                .build();
    }
}
关键代码
String question = "介绍一下宝鸡文理学院";
List
<Document> documents = vectorStore.similaritySearch(
        SearchRequest.builder()
                        .topK(3)
                        .similarityThreshold(0.3)
                        .query(question)
                        .build());

String template = """
        请基于以下上下文回答问题:
        {documents}

        用户问题:{question}
        """;
PromptTemplate promptTemplate = new PromptTemplate(template);
promptTemplate.add("documents", documents.stream()
        .map(Document::getText)
        .collect(Collectors.joining("\n")));
promptTemplate.add("question", question);

String content = ollamaChatClient.prompt(promptTemplate.create()).user(question).call().content();
效果展示
当我们输入向量数据库中不匹配的数据时,例如: “介绍一下宝鸡文理学院”

我们发现,系统会忽略向量数据库中的文档内容,根据大模型直接输出内容。
如果,我们输入的内容在向量数据库中存在时,例如:”西安9月1日穿什么”

我们发现,大模型是根据我们的文档内容进行回答的。
至此,RAG 通过结合检索和生成能力,能从外部知识库搜索相关信息,生成更准确的回应,有效克服了大模型在知识更新上的短板。
重排序
在检索增强生成(RAG)系统中,重排序(Reranking) 是位于“初步检索(Retrieval)”之后、“大模型生成(Generation)”之前的一个关键步骤。
你可以把它通俗地理解为一位专业的质检员或决赛裁判:
- 初步检索就像是海选,为了不漏掉有用信息,系统通常会快速从海量数据中捞出几十甚至上百个可能相关的文档片段(例如
Top-50到Top-100)。 - 重排序就像是专家评审,它会对这批候选文档进行极其严格的二次筛选和打分,从中挑出最顶尖、最相关的少数几个片段(例如
Top-3到Top-5),然后才把这些“高质量证据”交给大模型去生成最终答案。
为什么需要重排序?
初步的向量检索(Embedding)虽然速度极快,但存在固有的局限性。向量模型计算的是语义相似度,但相似并不等于能精准回答问题。例如,查询狗的训练方法,向量检索可能会召回与宠物护理或动物行为理论高度相似的内容,但这并不能直接解决用户的具体问题。
如果直接把初步检索到的大量文档塞给大模型,不仅会浪费计算资源(Token 成本),还会引入噪音,稀释真正有用的信息,甚至导致大模型产生幻觉。重排序正是为了解决这一痛点,确保大模型只依赖最高质量的上下文进行推理。
核心工作原理
重排序模型(Rerank Model)通常采用交叉编码器(Cross-Encoder)架构。与初步检索时分别计算查询和文档向量不同,交叉编码器会将用户查询和候选文档拼接在一起,作为一个完整的序列输入到模型中。
通过深度注意力机制(Cross-Attention),模型能够同时分析查询和文档之间的每一个词元,进行极其细致的语义交互。这使得它能捕捉到非常微妙的关联性,例如某个文档虽然没有完全匹配的关键词,但其内在逻辑完美回答了问题。最终,模型会为每个文档计算出一个精确的相关性得分,并据此重新排序。
重排序带来的核心优势
- 显著提升答案质量:通过去粗取精,确保大模型拿到的参考资料是最精准的,从而有效减少幻觉,提高回答的准确性和可信度。
- 降低 Token 消耗:只需将精选出的少量文档传递给大模型,大幅节省了输入
Token的成本。 - 增强系统鲁棒性:即使初步检索阶段存在偏差或错误,重排序也能在一定程度上纠正这些错误,提升系统的整体容错率。
实现过程
在 Spring AI 结合 Elasticsearch 构建 RAG 系统时,重排序是提升检索精度的关键步骤。通常的做法是先通过向量检索召回一批候选文档,然后使用重排序模型对这些文档进行精细打分和排序。我们这里使用 spring-test 来进行测试。
-
在
application.yml文件中添加Rerank配置spring: ai: rerank: model: 'BAAI/bge-reranker-v2-m3' # SiliconFlow 重排序模型 top-n: 10 # 重排序后保留的 Top-N 结果数量注意:重排序模型最好与
Embedding模型出自同一团队,这样在训练数据分布上更一致,效果更佳。bge-reranker-v2-m3是目前开源界效果最好的多语言Rerank模型,由BAAI发布,SiliconFlow免费提供API。 -
创建
SiliconFlowRerankClient重排序服务/** * 基于 SiliconFlow Rerank API 的重排序服务 * <p> * 调用 SiliconFlow 的 /v1/rerank 接口,对向量检索返回的候选文档进行二次精排, * 提升最终检索结果的相关性。 */ @Slf4j @Service public class SiliconFlowRerankClient { private final RestClient restClient; @Value("${spring.ai.rerank.model}") private String model; @Value("${spring.ai.rerank.top-n}") private int topN; /** * 构造 RestClient,复用 SiliconFlow 的 base-url 和 api-key */ public SiliconFlowRerankClient(RestClient.Builder builder, @Value("${spring.ai.openai.base-url}") String baseUrl, @Value("${spring.ai.openai.api-key}") String apiKey) { this.restClient = builder .baseUrl(baseUrl) // 为所有的请求添加默认的 HTTP 请求头。这里设置了身份认证头,格式为 Bearer <你的API密钥>,这是调用硅基 流动等 AI 平台 API 的标准鉴权方式。 .defaultHeader(HttpHeaders.AUTHORIZATION, "Bearer " + apiKey) // 设置默认的请求体内容类型为 application/json,告诉服务器客户端发送的数据格式是 JSON。 .defaultHeader(HttpHeaders.CONTENT_TYPE, MediaType.APPLICATION_JSON_VALUE) .build(); } /** * 对候选文档进行重排序 * * @param query 用户查询文本 * @param documents 向量检索返回的候选文档列表 * @return 按相关性重新排序后的 Top-N 文档(附带 rerank_score) */ public List <Document> rerank(String query, List<Document> documents) { if (documents == null || documents.isEmpty()) { log.warn("No documents to rerank"); return Collections.emptyList(); } // 提取文档文本内容 List <String> docTexts = documents.stream() .map(Document::getText) .collect(Collectors.toList()); // 构造请求体 RerankRequest request = new RerankRequest(); request.setModel(model); request.setQuery(query); request.setDocuments(docTexts); request.setTopN(Math.min(topN, documents.size())); try { RerankResponse response = restClient.post() .uri("/v1/rerank") .body(request) .retrieve() .body(RerankResponse.class); if (response == null || response.getResults() == null) { log.warn("Rerank API returned null, fallback to original order"); return documents.subList(0, Math.min(topN, documents.size())); } // 按 rerank 得分重新排序 List <Document> reranked = new ArrayList<>(); for (RerankResult result : response.getResults()) { if (result.getIndex() != null && result.getIndex() < documents.size()) { Document doc = documents.get(result.getIndex()); doc.getMetadata().put("rerank_score", result.getRelevanceScore()); reranked.add(doc); } } return reranked; } catch (Exception e) { log.error("Rerank API call failed, fallback to original Top-K results", e); return documents.subList(0, Math.min(topN, documents.size())); } } // ---- 请求/响应 DTO ---- @Data static class RerankRequest { private String model; private String query; private List <String> documents; @JsonProperty("top_n") private Integer topN; } @Data static class RerankResponse { private List <RerankResult> results; } @Data static class RerankResult { private Integer index; @JsonProperty("relevance_score") private Double relevanceScore; } }注意:这段代码不需要自己书写,
copy即可。如果后期要更换大模型平台注意更换uri即可。 -
App中进行测试String query = "推荐一些哲学相关图书"; // Step 1: 向量检索 — 拉取更多候选 SearchRequest searchRequest = SearchRequest.builder() .query(query) .similarityThreshold(0.3) .topK(50) .build(); List <Document> candidates = vectorStore.similaritySearch(searchRequest); // Step 2: 重排序 — 用 Rerank 模型对候选文档重新打分排序 List <Document> reranked = siliconFlowRerankClient.rerank(query, candidates); // Step 3: 输出精排结果 for (int i = 0; i < reranked.size(); i++) { Document doc = reranked.get(i); Object score = doc.getMetadata().get("rerank_score"); log.info("[{}] rerank_score={}, content={}", i + 1, score, doc.getText()); } -
测试效果
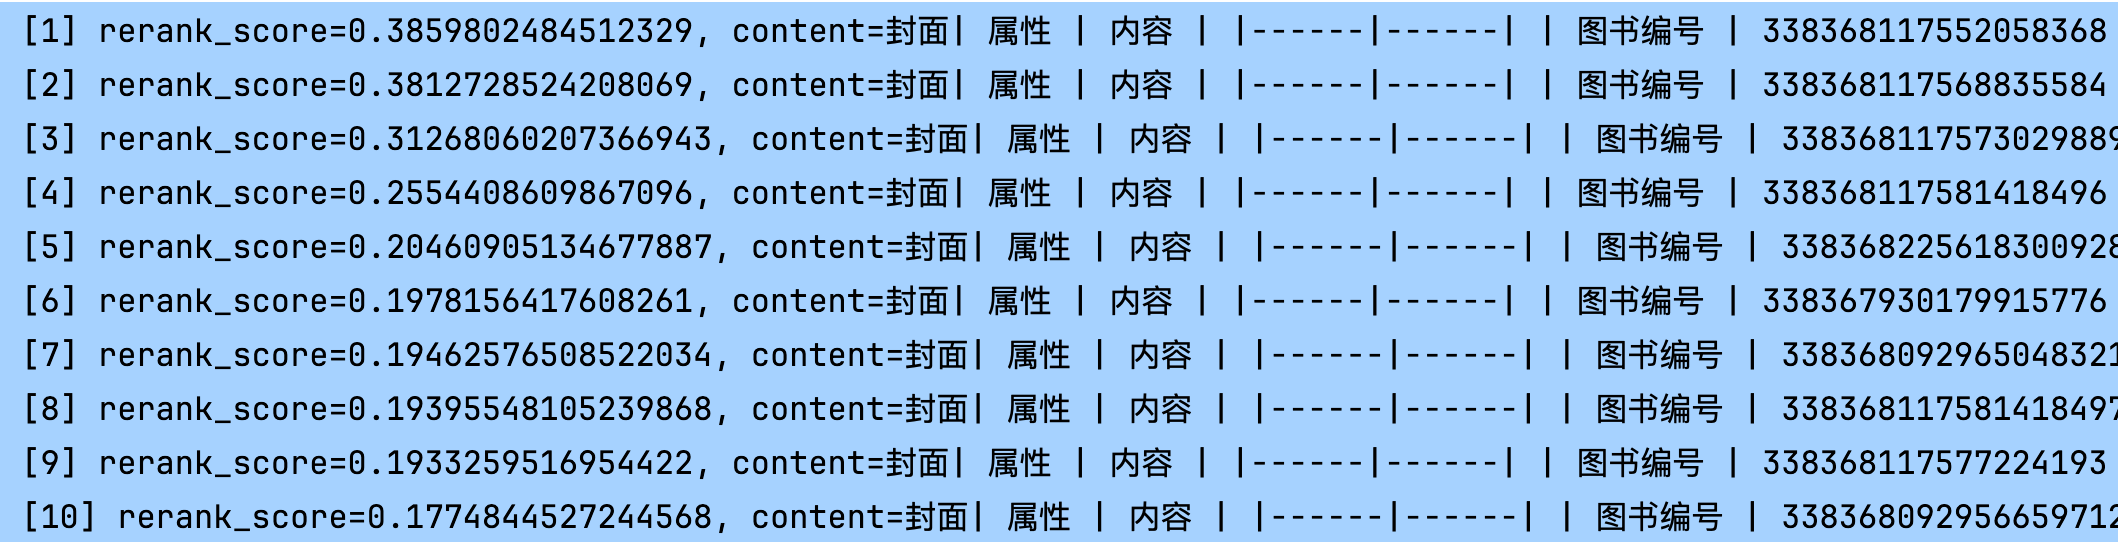
为什么我使用重排序后分数更低了?
重排序(
Rerank)后的分数(relevance_score)都在0.17到0.38之间,很多开发者初次使用时都会产生“分数太低,是不是模型出错了”的疑虑。请放心,这是完全正常的现象,你的模型并没有出问题。
以下是导致分数看起来“偏低”的核心原因及应对建议:
分数低的核心原因:
Logit与概率的区别硅基流动上托管的许多重排序模型(如
BAAI/bge-reranker-v2-m3),其底层输出的是Logit(对数几率) 或未经完全归一化的原始分数,而不是严格意义上 0 到 1 之间的概率值。
只有部分模型返回的是 0 到 1 的绝对概率。
对于返回
Logit的模型,分数可能会集中在某个区间(比如 0.1 ~ 0.4),这仅仅反映了文档之间的相对相关性,而不是绝对概率。重排序的本质是“相对排名”而非“绝对打分”
重排序模型(
Cross-Encoder)的核心价值在于“排得准”而不是“分得高”。
它的任务是让对的文档排在错的文档前面。
只要排在前面的文档分数高于排在后面的文档,并且符合业务预期,这个分数就是有效的。从你的日志来看,排名靠前的《哲学家们都干了些什么》(0.385)确实比排名靠后的《刘擎西方现代思想讲义》(0.177)分数高,这说明模型正在正确地履行精排的职责。
工程优化建议:不要使用绝对阈值
在实际的
RAG工程落地中,强烈建议不要使用绝对分数阈值(例如if (score > 0.8) return doc)来过滤文档,因为不同模型、甚至同一模型在不同Query下的分数分布差异极大。
重排序就是 RAG 检索流程中的精排专家,在初步检索捞出大量候选文档后,利用更强大的交叉注意力模型对它们进行精细打分和重新排序,从而把最精准、最相关的结果筛选出来喂给大模型。
混合检索
纯向量检索 + Rerank 虽然比最基础的 RAG 好,但依然有瓶颈。在 RAG 的工程实践中,“混合检索(Hybrid Search)+ Rerank” 才是目前公认的标准生产级架构。
在 RAG 系统中,混合检索,又称融合检索或多路召回。是一种在检索过程中同时使用多种检索方式,并将多种检索结果进行融合,从而得到最终检索结果的技术策略。
它的核心思想是结合不同检索方式的优势,弥补单一检索方式的不足,从而显著提升检索结果的准确性、召回率和相关性。
核心组成
混合检索通常结合了以下两种主流的检索技术:
- 基于关键字的搜索(全文搜索):
- 工作原理:通过分析查询与文档之间共享字词的频率和分布来确定相关性。查询中的字词在文档中出现的频率越高,文档的相关性分数就越高(例如使用
BM25算法)。 - 优势:在精确匹配方面表现出色,非常适合包含特定术语、产品名称或非描述性技术术语的查询。
- 工作原理:通过分析查询与文档之间共享字词的频率和分布来确定相关性。查询中的字词在文档中出现的频率越高,文档的相关性分数就越高(例如使用
- 语义搜索(向量搜索):
- 工作原理:使用嵌入模型将文本转换为捕获其语义含义的向量表示。通过比较查询向量与文档向量的相似度(如余弦相似度)来检索结果。
- 优势:能够捕捉更广泛的上下文信息,即使文档中没有包含查询的确切关键字,也能检索到概念上相似的文档,对拼写错误和同义词具有鲁棒性。
工作流程
混合检索的具体执行过程通常包含以下步骤:
- 并行检索:系统首先同时执行语义搜索和基于关键字的搜索,分别获取两组概念上相关或字面上匹配的候选文档集。
- 结果融合与重排序:将两路检索返回的结果进行合并。为了进一步优化,通常会引入重排序模型或采用倒数排名融合(
RRF)等算法,根据综合相关性对文档进行重新排序,优先呈现最相关、最有价值的信息。
适用场景
- 兼顾精确性与语义理解:它既利用了关键字匹配的精度,又结合了语义理解的深度,确保检索到的文档既包含用户询问的特定术语,又在语义上高度相关。
- 最佳用例:适用于大多数复杂的查询场景,特别是那些同时包含语义术语和技术术语的查询。例如:“我如何打开
HD7-8D?”(其中“打开”是语义概念,而HD7-8D是需要精确匹配的技术型号)。
代码实现
下面我们来基于 SpringAI + Elasticsearch8.15.5 + BM25 算法分别实现语义检索、精确度检索和合并操作。
语义检索
这里的代码没什么好解释的,就是前边的内容,我们使用 KNN 算法实现:
SearchRequest searchRequest = SearchRequest.builder()
        .query(question)
        .similarityThreshold(0.3)
        .topK(40)
        .build();
List
<Document> knnList = vectorStore.similaritySearch(searchRequest);KNN(K-Nearest Neighbors,K 近邻)算法是一种经典的监督学习算法,主要用于分类和回归问题。它的核心思想非常直观,可以概括为物以类聚,人以群分,即一个样本的类别或数值,可以由其在特征空间中最相似的 K 个邻居来决定。
精确度检索
关键字检索这里我们使用 BM25 算法实现。需要注意的是,原先的 VectorStore 并没有封装精确度检索的操作。我们需要引入 ElasticsearchClient 对象来实现精确度检索操作。
-
问题向量化
String question = "你能帮我查询一些哲学方面的图书么?";
float[] embedding = embeddingModel.embed(question);
List
<Float> queryVector = new ArrayList<>(embedding.length);
for (float v : embedding) {
    queryVector.add(v);
}
注意:这里要引入
EmbeddingModel模型对问题进行向量化操作。 -
构建并执行
BM25检索请求SearchResponse <Document> searchResponse = elasticsearchClient.search(s -> s.index(indexName) // 使用 match 查询,ES 默认会使用 BM25 进行打分 .query(q -> q.match(m -> m // 指定要进行全文检索的文本字段 SpringAI在存储时默认的名称,如果要根据标题查询这里写title .field("content") .query(question) // 用户的查询文本 .boost(1.0f) // 调整该字段(content)的权重 ) ).size(40), Document.class);什么是权重?
在 Elasticsearch 中,权重(
Weight) 是一个用来修改文档相关性评分(_score)的参数,默认值是1.0。通俗地讲,权重就是告诉搜索引擎:当用户搜索某个词时,如果这个词出现在这个字段里,请给这个文档更高的加分。
举个生动的例子
假设你有一个图书索引,里面有两个文本字段:
title(书名)和content(内容简介)。当用户搜索哲学家时:
- 如果一本书的书名叫《哲学家们都干了些什么》,另一本书只是在内容简介里顺带提了一句哲学家。
- 显然,书名里包含哲学家的书,与用户的搜索意图更匹配。
为了让搜索引擎明白这一点,你就可以给
title字段设置更高的权重:// 书名匹配到的重要性是内容简介的 3 倍 .field("title^3", "content")权重是如何工作的?
- 默认权重 (1.0):如果你不设置,所有字段的权重都是
1.0,搜索引擎会一视同仁地计算相关性。 - 提高权重 (> 1.0):例如设置为
2.0或3.0,那么在这个字段匹配到关键词时,文档的最终得分(_score)会被放大,从而在搜索结果中排名更靠前。 - 降低权重 (0 ~ 1.0):例如设置为
0.5,会降低该字段匹配时对最终得分的贡献。
-
解析响应并提取文档
List
<Document> bm25List = searchResponse.hits().hits()
        .stream().map(Hit::source)
        .filter(Objects::nonNull)
        .toList();
我们已经通过精确度查询获取到了相关的文档信息,下来我们可以将两个集合进行合并操作。
合并操作
目前的主流操作主要有两种:
RRF融合- 直接合并去重后
Rerank
这是目前主流的两种操作,当然第一种方式用户还是更多一些的。
-
RRF融合BM25的分数可能高达 10.0,而KNN的分数通常在 0.0~1.0 之间,两者量纲完全不同,绝对不能直接相加。RRF算法的巧妙之处在于:它抛弃了原始分数,只看文档在各自列表中的“排名(Rank)”。RRF 公式:
Score = 1 / (k + rank)rank:文档在结果列表中的名次(从 1 开始)。k:平滑常数(通常取 60),用来防止排名靠前的文档分数过于夸张。
如果一个文档在
KNN列表排第 2,在BM25列表排第 3,它的RRF分数就是:1/(60+2) + 1/(60+3) = 0.0161 + 0.0158 = 0.0319int k = 60; // 平滑常数 int top = 40; // 返回条数 // 使用 LinkedHashMap 保持插入顺序,Key 为文档唯一标识,Value 为累加的 RRF 分数 Map<String, Double> scoreMap = new LinkedHashMap<>(); Map<String, Document> docMap = new HashMap<>(); // 计算 KNN 列表的 RRF 分数 for (int i = 0; i < knnList.size(); i++) { Document doc = knnList.get(i); String id = doc.getId(); double rrfScore = 1.0 / (k + i + 1); scoreMap.merge(id, rrfScore, Double::sum);// 如果已存在则累加 docMap.putIfAbsent(id, doc); } // 计算 BM25 列表的 RRF 分数并累加 for (int i = 0; i < bm25List.size(); i++) { Document doc = bm25List.get(i); String id = doc.getId(); double rrfScore = 1.0 / (k + i + 1); scoreMap.merge(id, rrfScore, Double::sum); docMap.putIfAbsent(id, doc); } // 按 RRF 综合分数降序排序,并截取 Top-K List <Document> rrfList = scoreMap.entrySet().stream() .sorted(Map.Entry.<String, Double>comparingByValue().reversed()) .limit(top) .map(entry -> { Document doc = docMap.get(entry.getKey()); // 将融合后的分数放入 metadata,方便后续排查 doc.getMetadata().put("rrf_score", entry.getValue()); return doc; }).toList();需要注意的是,自动化
RRF操作需要Elasticsearch的白金会员或者企业会员,我们这里使用手动方式实现的RRF融合操作,融合完成后将数据传递给Rerank模型进行重排序操作,省略了重排序代码。 -
合并去重
// 使用 LinkedHashMap 保持顺序并去重(Key 为文档 ID,Value 为文档对象)
Map<String, Document> mergedMap = new LinkedHashMap<>();

// 优先放入 KNN 的结果(通常语义相关性更稳定)
for (Document doc : knnList) {
    if (doc.getId() != null && mergedMap.size() < 40) {
        mergedMap.putIfAbsent(doc.getId(), doc);
    }
}

// 补充 BM25 的结果(用于捕获精确关键词)
for (Document doc : bm25List) {
    if (doc.getId() != null && mergedMap.size() < 40) {
        mergedMap.putIfAbsent(doc.getId(), doc);
    }
}
// 转换成 list 集合
List
<Document> documents = new ArrayList<>(mergedMap.values());
这种代码和简单,我们可以直接通过
Map的特性将重复的文档去重,然后在将去重后的文档扔给Rerank进行重排序操作。这里省略了重排序的代码。
这两种方式的比较
| 特性 | RRF 融合后 -> Rerank | 直接合并去重 -> Rerank |
|---|---|---|
| 排序质量 | 极高。RRF 相当于让两路检索投票,两路都认可的文档会获得极高的初始权重, Rerank 在此基础上微调,极难翻车。 |
较高。Rerank 模型自己判断相关性,但如果候选集太大(比如 80 条), Rerank 可能会因为注意力分散而产生“幻觉”或漏掉好文档。 |
| 代码复杂度 | 较高(需要手写 RRF 算法)。 |
极低(只需几行去重代码)。 |
| 适用场景 | 生产级 RAG 系统,对准确率要求极高。 |
快速验证、个人项目,或者 Rerank 模型极其强大。 |
如果是为了快速跑通流程、验证效果,直接合并去重丢给 Rerank 是完全没问题的。
但如果未来要把这个系统上线到生产环境,强烈建议加上 RRF 融合,因为 RRF 能在不增加任何 AI 推理成本的前提下,把候选集的底子打得更好,让 Rerank 的工作事半功倍。
关老师好厉害